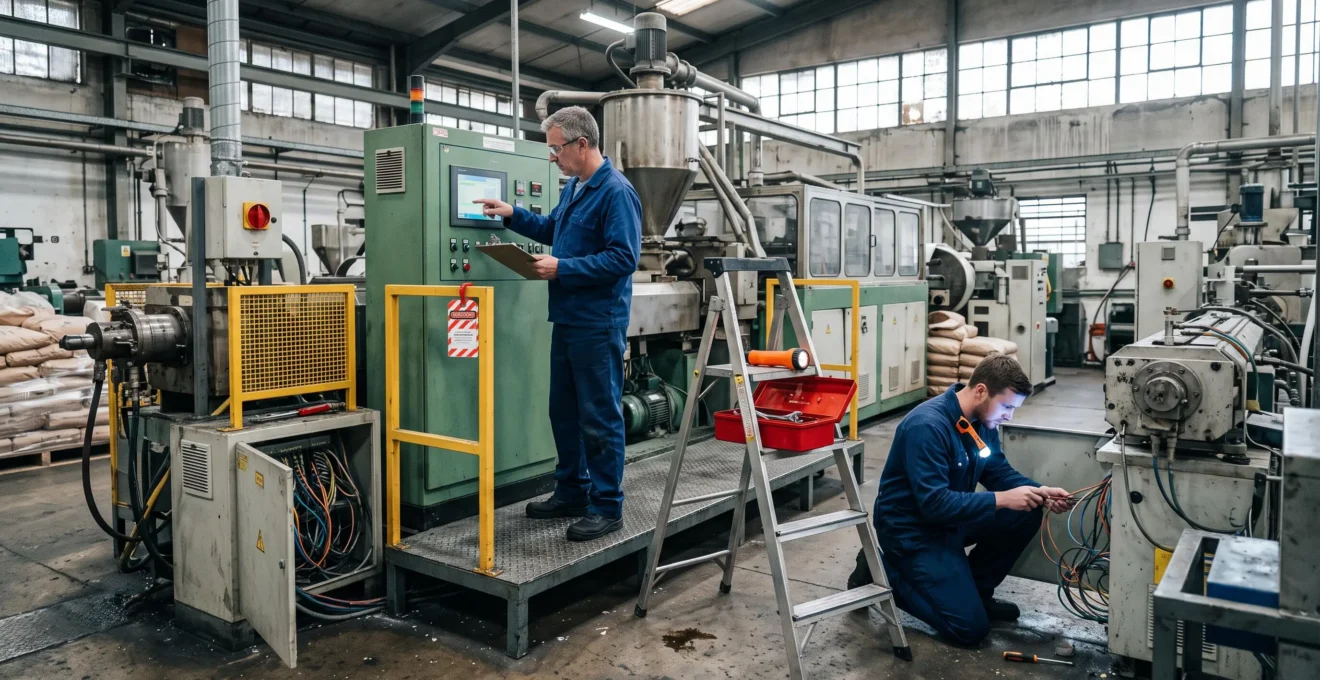
Une ligne d’extrusion immobilisée, une presse à injecter qui redémarre après plusieurs interventions ou un moteur régulièrement en surchauffe : chaque arrêt non planifié désorganise la production, compromet les délais et mobilise des ressources de maintenance. Lorsque les pannes se répètent, accélérer les réparations ne suffit plus.
Réduire de 50 % les arrêts non planifiés en six mois peut constituer un objectif de progrès, à condition de le confronter à la situation initiale de l’usine. Cette réduction n’est ni un résultat garanti ni une performance démontrée par les sources présentées ici. Elle exige de mesurer les pertes, d’identifier les équipements les plus pénalisants et de supprimer les mécanismes responsables des défaillances.
La démarche associe analyse de Pareto, recherche des causes racines, méthodes 8D et 5 Pourquoi, surveillance des dérives et amélioration de l’organisation des interventions. Pour un responsable production ou maintenance confronté à des indisponibilités récurrentes, l’enjeu est de transformer les historiques de pannes en décisions vérifiables, sans sacrifier la sécurité ni la qualité.
Les leviers essentiels pour réduire les arrêts imprévus
- Classer les équipements selon leur durée cumulée d’immobilisation pour concentrer les efforts sur les pertes réellement dominantes.
- Confirmer les causes racines techniques et organisationnelles avant de généraliser les actions correctives.
- Piloter un programme de six mois à partir de la récurrence des pannes, du temps d’arrêt et de l’efficacité des réparations.
- Pourquoi 3 équipements sur 15 génèrent la majorité de vos arrêts de production ?
- Comment identifier la vraie cause racine d’une panne récurrente en 8 étapes structurées ?
- Pourquoi vos pannes reviennent-elles quelques semaines après la réparation ?
- Comment prévenir les arrêts liés aux surchauffes moteurs grâce à la surveillance thermique ?
- Quelle méthode pour prioriser vos actions correctives : AMDEC, criticité ou quick wins ?
- Pourquoi vos réparations durent deux fois plus longtemps : le diagnostic par essai-erreur
- Comment mener une analyse 5M pour éliminer définitivement vos bavures ?
- Comment réduire votre MTTR de plusieurs heures grâce à une organisation optimale de la maintenance ?
Pourquoi 3 équipements sur 15 génèrent la majorité de vos arrêts de production ?
Une minorité d’équipements peut concentrer l’essentiel des pertes de disponibilité lorsque certaines machines cumulent des pannes longues ou bloquent une ligne complète. Le diagramme de Pareto permet de repérer cette concentration. Cependant, trois équipements sur quinze ne représentent pas systématiquement une proportion déterminée des arrêts : chaque usine doit mesurer sa propre répartition.
Le premier réflexe consiste à extraire les événements de la gestion de maintenance assistée par ordinateur (GMAO) sur une période représentative. Pour chaque arrêt, les informations utiles comprennent l’équipement concerné, le début et la fin de l’immobilisation, la symptomatologie et les interventions réalisées.
Le classement doit ensuite privilégier le temps d’arrêt cumulé plutôt que le seul nombre de pannes. Une machine qui tombe fréquemment en panne mais redémarre rapidement peut pénaliser moins la production qu’une extrudeuse victime d’une immobilisation prolongée.
La méthode de construction du diagramme de Pareto présentée par l’ASQ autorise notamment des classements selon la fréquence, le coût ou le temps. Le choix de la mesure doit correspondre au problème étudié.
Pour identifier les équipements prioritaires, la démarche peut suivre quatre opérations :
- Regrouper les arrêts par équipement en excluant ou distinguant les arrêts planifiés.
- Calculer la durée cumulée d’immobilisation imputable à chaque équipement.
- Classer les équipements par durée décroissante et calculer leur part dans le total.
- Examiner les premiers du classement pour vérifier les causes et l’impact économique réel.
La part des trois premiers équipements se calcule ainsi : durée cumulée des arrêts imputés à ces trois équipements, divisée par la durée totale des arrêts retenus, puis multipliée par 100. Ce pourcentage constitue un indicateur mensuel de concentration, et non une règle universelle.
Dans la plasturgie, la criticité dépend aussi des conséquences industrielles : immobilisation d’une presse sans solution de substitution, défaut de séchage matière, arrêt du refroidissement ou perturbation d’une ligne de thermoformage. Croiser durée, coût horaire et commandes exposées aide à départager des équipements présentant des pertes similaires.
Attention aux erreurs d’attribution. Un convoyeur arrêté par une défaillance située en amont ne doit pas nécessairement être considéré comme la cause primaire de l’immobilisation. La vérification des journaux d’événements, des chronologies et des observations terrain évite de construire un Pareto trompeur.
Une fois les équipements critiques repérés, la priorité devient de comprendre pourquoi leurs défaillances se reproduisent, au lieu de traiter chaque arrêt comme un incident indépendant.
Comment identifier la vraie cause racine d’une panne récurrente en 8 étapes structurées ?
Une analyse des causes racines consiste à remonter du symptôme visible jusqu’aux mécanismes techniques et organisationnels qui rendent la panne possible. Une démarche en huit étapes permet de formuler le problème, réunir les preuves, tester les hypothèses et vérifier les corrections. Elle évite de confondre le remplacement d’un composant défaillant avec l’élimination de sa cause.
Considérons un scénario pédagogique hypothétique : une vis d’extrusion subit des ruptures répétées. Remplacer la vis rétablit momentanément la production, mais n’explique pas les contraintes responsables des dommages.
Une analyse structurée peut être organisée de la manière suivante :
- Définir le problème : préciser la nature de la rupture, sa localisation, les circonstances et les conséquences mesurées.
- Collecter les données : réunir historiques GMAO, paramètres de fonctionnement, alarmes, observations et références des pièces.
- Reconstituer la chronologie : identifier les événements précédant la défaillance, notamment les changements de matière, de réglage ou de cadence.
- Formuler les hypothèses : examiner notamment les surcharges mécaniques, anomalies de température, défauts d’assemblage et variations du procédé.
- Tester les hypothèses : confronter chaque possibilité aux mesures et inspections réalisées selon des procédures sûres.
- Confirmer la cause racine : établir un mécanisme cohérent avec les faits, en distinguant cause immédiate, cause technique profonde et facteur organisationnel.
- Définir la correction : choisir une action qui traite le mécanisme confirmé et formaliser les responsabilités.
- Vérifier l’efficacité : suivre l’équipement pendant une période adaptée au cycle de défaillance et contrôler les indicateurs retenus.
Les méthodes 5 Pourquoi et Ishikawa facilitent la construction des hypothèses. Les 5 Pourquoi approfondissent les relations causales, tandis que le diagramme d’Ishikawa permet d’organiser plusieurs familles de facteurs. Ni l’une ni l’autre ne dispense d’une vérification factuelle.
Cette logique rejoint les méthodes de résolution structurée des problèmes de l’ASQ, qui privilégient une définition factuelle du problème et l’exploitation de données quantitatives et qualitatives.
Une rupture peut ainsi résulter immédiatement d’une surcharge, elle-même favorisée par un réglage inadapté, rendu possible par l’absence de contrôle après changement de production. L’action corrective doit traiter les niveaux causaux effectivement établis, sans attribuer une défaillance à une erreur humaine par défaut.
Checklist opérationnelle pour lancer une analyse des causes racines
- Exporter les événements des équipements prioritaires : produire un tableau avec durées, dates et symptômes.
- Choisir une panne récurrente : rédiger une fiche décrivant les faits observés et l’impact sur la production.
- Construire les hypothèses : établir un diagramme causes-effets distinguant faits confirmés et causes possibles.
- Valider le mécanisme : conserver un compte rendu des contrôles et des éléments ayant confirmé ou écarté chaque hypothèse.
- Déployer et vérifier les corrections : créer une fiche d’action datée comprenant responsable, preuves de réalisation et critères d’efficacité.
La validation ne repose pas uniquement sur le redémarrage. Une cause est suffisamment étayée lorsque les observations expliquent la panne et que la correction produit les résultats attendus sur une durée d’exposition pertinente. L’absence momentanée de défaillance ne constitue pas, à elle seule, une preuve absolue.
Cette rigueur prend tout son sens lorsque les mêmes pannes réapparaissent malgré plusieurs interventions réputées terminées.
Pourquoi vos pannes reviennent-elles quelques semaines après la réparation ?
Une panne récurrente apparaît souvent parce que la réparation supprime sa manifestation sans éliminer le mécanisme qui l’a produite. Une pièce non conforme, un réglage incorrect, un remontage imparfait ou une validation insuffisante peuvent également réintroduire le défaut. Pour distinguer ces situations, il faut comparer les interventions successives et les conditions réelles de redémarrage.
Sur une ligne d’injection, remplacer plusieurs fois un capteur ne résout rien si celui-ci est régulièrement exposé à des conditions incompatibles avec ses spécifications. À l’inverse, constater plusieurs défauts sur le même équipement ne signifie pas nécessairement qu’ils partagent une cause commune.
La GMAO doit permettre de rapprocher au minimum l’équipement, le symptôme, le composant concerné, la cause présumée, les pièces remplacées et la date de remise en service. Une fenêtre d’observation de trois à six mois peut servir de point de départ, à adapter à la fréquence d’utilisation et aux cycles de défaillance.
La cohérence des comptes rendus joue un rôle déterminant. Une publication du NIST sur l’analyse des historiques de maintenance souligne que des techniciens peuvent décrire différemment des problèmes similaires. Cette variabilité complique leur regroupement et l’exploitation des relations entre défaillances et causes.
Un indicateur utile est le taux de récurrence, défini localement comme la proportion des incidents présentant un même symptôme confirmé sur un équipement pendant une période donnée. Il faut fixer précisément le périmètre et le dénominateur avant de comparer les résultats. Aucun seuil universel ne s’applique indistinctement à toutes les installations.
Les pressions de production accentuent le phénomène. Une réparation provisoire peut devenir une solution permanente lorsque la ligne redémarre sans contrôle des conditions de fonctionnement. Avant la remise en production, un responsable désigné doit pouvoir vérifier la conformité de l’intervention, les dispositifs de sécurité, les paramètres pertinents et les essais nécessaires.
Enfin, examiner les références et lots des pièces utilisées lors des trois dernières interventions peut révéler une substitution inadaptée. Cette vérification doit précéder toute conclusion sur un défaut intrinsèque de la machine.
La suppression des récurrences doit ensuite être complétée par une surveillance des signes avant-coureurs, particulièrement lorsque les défaillances se manifestent par une dérive thermique.
Comment prévenir les arrêts liés aux surchauffes moteurs grâce à la surveillance thermique ?
La surveillance thermique contribue à prévenir les arrêts moteurs en repérant des températures anormales ou des dérives inhabituelles avant une défaillance. Sur les extrudeuses et presses à injecter, elle peut orienter le diagnostic vers une surcharge, un défaut de refroidissement ou un problème mécanique. Son efficacité dépend du choix des points mesurés et de la prise en compte des conditions d’exploitation.
Une température élevée ne suffit pas à identifier une cause racine. Un carter moteur plus chaud qu’à l’habitude peut traduire une ventilation obstruée, une charge excessive ou une élévation de la température ambiante. Les défauts d’alignement et de roulements peuvent également provoquer des échauffements localisés.
Pour interpréter correctement les mesures, il faut enregistrer les conditions dans lesquelles elles sont réalisées : vitesse, charge, température ambiante, état du procédé et régime de fonctionnement. Une comparaison entre mesures obtenues à des charges très différentes peut conduire à une fausse alerte.
La mise en place peut suivre trois niveaux :
- Effectuer des relevés thermographiques périodiques sur les moteurs et points critiques accessibles.
- Constituer une référence thermique par équipement et définir les seuils de surveillance adaptés.
- Installer une surveillance continue sur les machines dont l’immobilisation aurait les conséquences les plus importantes.
Les seuils doivent combiner les limites techniques prescrites pour l’équipement et l’observation de son comportement normal. L’historique thermique ne doit jamais justifier le dépassement des limites constructeur. Une dérive progressive mérite une analyse même lorsque la température absolue reste inférieure à un seuil de protection.
Une hiérarchie à trois niveaux évite de transformer la surveillance en accumulation d’alarmes. La pré-alerte déclenche une vérification, l’alerte impose un diagnostic planifié selon la criticité, et l’alerte critique appelle l’application des procédures de sécurité et de protection prévues pour l’équipement.
Les faux positifs doivent être examinés sans neutraliser les protections nécessaires. Une caméra thermique révèle une répartition de températures de surface, mais ne remplace ni les mesures électriques, ni les contrôles mécaniques, ni l’examen des conditions de refroidissement.
Les alertes détectées doivent ensuite être intégrées à une méthode de priorisation : toutes les anomalies ne présentent pas le même risque ni le même potentiel de perte de production.
Quelle méthode pour prioriser vos actions correctives : AMDEC, criticité ou quick wins ?
L’AMDEC, la grille de criticité et les quick wins répondent à des besoins complémentaires. L’AMDEC approfondit les modes de défaillance et leurs effets, la criticité facilite les arbitrages entre risques et les quick wins permettent de traiter rapidement certains problèmes simples. Une stratégie efficace combine ces méthodes selon la gravité des conséquences, la qualité du diagnostic et les ressources disponibles.
Le choix ne doit pas dépendre uniquement du coût ou de la rapidité d’exécution. Un défaut présentant un risque pour la sécurité, l’intégrité d’un équipement ou la conformité du produit exige un traitement adapté, même lorsque sa correction est longue ou coûteuse.
Le tableau suivant aide à affecter chaque méthode à la bonne situation.
| Approche | Usage privilégié | Limite à maîtriser |
|---|---|---|
| AMDEC | Étudier en profondeur les modes de défaillance des équipements majeurs. | Mobilise du temps et nécessite des connaissances techniques fiables. |
| Grille de criticité | Comparer rapidement les conséquences, la probabilité et les priorités d’action. | Une cotation subjective peut fausser le classement. |
| Quick wins | Corriger sans délai des anomalies simples dont les causes sont établies. | Une amélioration immédiate peut masquer une défaillance persistante. |
Le Pareto des durées d’arrêt constitue un bon point d’entrée : les équipements concentrant les pertes justifient une analyse approfondie. L’AMDEC permet ensuite de structurer les scénarios de défaillance, tandis qu’une grille multicritère aide à arbitrer les interventions.
Dans une usine de plasturgie, un plan de six mois peut être organisé progressivement :
- Mois 1 : fiabiliser les historiques, établir les pertes de référence et identifier les équipements prioritaires.
- Mois 2 : confirmer les premières causes et appliquer les corrections rapides dont les risques sont maîtrisés.
- Mois 3 et 4 : mener les analyses détaillées sur les équipements critiques et réaliser les modifications de fond.
- Mois 5 et 6 : vérifier les effets, ajuster les gammes de maintenance et standardiser les solutions validées.
Chaque action doit comporter un responsable, une échéance, un mécanisme causal identifié et une mesure d’efficacité. Par exemple, déboucher une ventilation est une correction rapide, mais une obstruction récurrente peut également révéler un problème d’environnement ou de conception nécessitant un traitement durable.
Le suivi doit comparer les résultats à la situation initiale, en tenant compte des volumes produits, du temps de fonctionnement et des changements de procédé. Sans ces précautions, une diminution des arrêts peut simplement refléter une baisse d’activité.
La priorisation gagne encore en efficacité lorsque les équipes réduisent les diagnostics improvisés, qui mobilisent inutilement du temps et des pièces de rechange.
Pourquoi vos réparations durent deux fois plus longtemps : le diagnostic par essai-erreur
Le diagnostic par essai-erreur allonge les réparations lorsqu’un technicien remplace successivement plusieurs composants sans avoir vérifié l’hypothèse de défaillance. Cette pratique multiplie les démontages, les essais et parfois les réinterventions. Elle peut expliquer une partie des délais, mais un temps de réparation élevé peut aussi provenir de l’attente de pièces, de l’accès machine ou des opérations de sécurité.
Une recherche de panne devient inefficace lorsque l’intervenant ne dispose ni d’une description fiable du symptôme, ni de schémas techniques actualisés, ni d’un historique exploitable. Le risque augmente lorsque la connaissance d’une installation repose exclusivement sur un technicien expérimenté.
Plusieurs signaux permettent de repérer ce phénomène dans les rapports d’intervention :
- Plusieurs pièces successivement remplacées avant le rétablissement du fonctionnement.
- Des tests répétés sans hypothèse explicitement formulée.
- Un temps de diagnostic supérieur au temps de réparation effective.
- Une intervention rouverte peu après sa clôture pour un symptôme identique.
Le dernier point ne prouve pas à lui seul un diagnostic erroné. Il indique qu’une investigation complémentaire peut être nécessaire.
Pour quantifier les pertes, chaque intervention longue devrait distinguer les temps consacrés à la détection, au diagnostic, à la préparation et à la consignation, à l’approvisionnement, à la réparation et à la validation. Ce découpage permet de savoir si le principal problème relève réellement du diagnostic.
Les leviers d’amélioration sont concrets : documenter les symptômes récurrents, rendre accessibles les schémas et les notices, utiliser des arbres de diagnostic, conserver les mesures ayant confirmé la panne et organiser la transmission des connaissances entre techniciens.
La standardisation des comptes rendus renforce cette démarche. Un historique structuré permet de retrouver des situations comparables sans supposer que deux incidents portant la même désignation possèdent nécessairement la même cause.
Il faut également éviter qu’une volonté de réduire les délais n’encourage des essais dangereux ou le contournement des protections. Les opérations de diagnostic doivent respecter les conditions de sécurité de l’équipement et les procédures d’intervention applicables.
La même exigence de vérification des hypothèses s’applique aux défauts de qualité : un symptôme observé sur une pièce injectée peut provenir de plusieurs familles de causes distinctes.
Comment mener une analyse 5M pour éliminer définitivement vos bavures ?
Une analyse 5M permet d’organiser les causes possibles des bavures en injection plastique autour de cinq familles : Matière, Matériel, Méthode, Main-d’œuvre et Milieu. Elle aide à distinguer les anomalies liées au moule, à la presse, aux paramètres du procédé ou aux conditions de fabrication. L’élimination durable du défaut dépend ensuite de mesures confirmant la cause réelle.
Une bavure correspond à un excès de matière qui s’échappe de la zone normalement délimitée par l’empreinte du moule. Elle peut apparaître notamment au plan de joint ou autour de certaines zones fonctionnelles du moule.
Avant toute réunion d’analyse, il faut constituer un dossier factuel : photographies localisées du défaut, historique des réglages, lots de matière, état du moule et fréquence d’apparition. Ces éléments évitent que le diagramme 5M se transforme en simple accumulation d’opinions.
La grille suivante permet de structurer les investigations sans présumer du résultat.
| Famille | Hypothèses à examiner | Vérifications utiles |
|---|---|---|
| Matière | Variabilité des propriétés ou des conditions de préparation. | Comparer lots, caractéristiques matière et conditions de séchage. |
| Matériel | Usure du plan de joint, défaut de fermeture ou force de verrouillage insuffisante. | Inspecter le moule et contrôler les paramètres mécaniques de la presse. |
| Méthode | Pression d’injection excessive ou séquence de réglage inadaptée. | Examiner les courbes de procédé et les paramètres validés. |
| Main-d’œuvre | Écart de réglage, absence de contrôle ou consigne ambiguë. | Comparer les pratiques aux instructions et aux enregistrements. |
| Milieu | Conditions environnementales susceptibles de modifier la stabilité du procédé. | Documenter les variations observées et rechercher une corrélation vérifiable. |
L’article technique de Protolabs sur les défauts du moulage par injection décrit notamment le rôle possible du plan de joint, des conditions de fermeture et des pressions d’injection dans l’apparition des bavures.
Une hypothèse ne devient une cause confirmée qu’après confrontation à des observations ou mesures pertinentes. Lorsque la bavure apparaît au même emplacement, l’inspection de la surface de fermeture peut par exemple être prioritaire. Si le défaut varie avec le cycle, les paramètres du procédé méritent une investigation spécifique.
Une fois le mécanisme établi, classer l’action évite les corrections inadaptées : réglage de procédé, maintenance du moule ou modification de conception. La disparition immédiate de la bavure doit être suivie d’une validation qualité dans des conditions représentatives, sans promettre une élimination définitive avant confirmation.
Cette démarche de diagnostic factuel contribue également à la fiabilité des interventions : mieux comprendre le problème réduit le risque d’actions répétées, tout en facilitant la préparation des réparations futures.
À retenir avant d’optimiser les temps de réparation
- Distinguer la prévention des pannes de la réduction de leur durée : les deux leviers doivent être pilotés séparément.
- Localiser le temps réellement perdu pendant une intervention avant d’investir dans des moyens supplémentaires.
- Capitaliser les causes confirmées dans les procédures afin d’améliorer simultanément diagnostic, réparation et prévention.
Comment réduire votre MTTR de plusieurs heures grâce à une organisation optimale de la maintenance ?
Réduire le MTTR exige d’identifier les étapes qui prolongent réellement la remise en état des équipements. La préparation des pièces, la standardisation du diagnostic, la disponibilité de l’outillage et la coordination des équipes peuvent raccourcir les interventions. L’ampleur du gain dépend toutefois des durées initiales, de la nature des pannes et du périmètre retenu pour mesurer la réparation.
Le MTTR, ou temps moyen de réparation, doit être défini de manière cohérente dans l’usine. Certaines organisations comptabilisent uniquement les opérations techniques ; d’autres intègrent les délais nécessaires au rétablissement du service. Pour éviter les comparaisons trompeuses, il faut conserver une définition stable et distinguer, si nécessaire, le MTTR technique du temps total d’indisponibilité.
Une intervention peut être décomposée en six phases :
- Détection et signalement de la panne.
- Diagnostic et identification du composant ou mécanisme en défaut.
- Préparation et approvisionnement des pièces et ressources nécessaires.
- Réparation, réglage ou remplacement selon la procédure appropriée.
- Contrôles de conformité, essais et validation de sécurité.
- Redémarrage et stabilisation du procédé.
La mesure des durées associées à chaque phase permet de déterminer où agir. Si l’attente d’une pièce domine, une meilleure procédure de diagnostic ne suffira pas. Si l’intervention nécessite des démontages répétitifs, la préparation d’un outillage dédié peut être plus pertinente.
Les équipements identifiés dans le Pareto des arrêts constituent un point de départ pour définir les pièces critiques à stocker. La décision doit toutefois intégrer les délais d’approvisionnement, les coûts de possession, les contraintes de conservation et les possibilités de mutualisation.
Les autres leviers organisationnels comprennent des fiches de diagnostic par symptôme, des gammes de démontage et remontage, des schémas accessibles, des kits d’intervention et une coordination préparée entre maintenance et production. Les consignations doivent rester conformes aux exigences de sécurité : réduire le MTTR ne signifie jamais supprimer des étapes protectrices.
Cas pratique hypothétique : objectif de réduction du MTTR
Une usine considère un scénario de départ avec un MTTR de six heures et fixe une cible de trois heures. Ce scénario est une illustration de pilotage, et non un résultat observé ou garanti.
L’équipe décompose ses interventions, identifie la phase dominante, formalise les actions adaptées et compare les mesures avant et après sur des pannes comparables. Si la baisse observée provient d’un changement dans le type de défaillances plutôt que d’une amélioration organisationnelle, le résultat doit être interprété avec prudence.
Au-delà du MTTR global, suivre le MTTR par famille d’équipements, le taux de réparation réussie au premier essai et la part des interventions rouvertes donne une lecture plus complète. Un MTTR en baisse accompagné d’une forte hausse des récurrences ne constitue pas une amélioration satisfaisante de la fiabilité.
Enfin, l’objectif de réduction des arrêts sur six mois doit être évalué à partir de la durée cumulée d’immobilisation non planifiée, rapportée au temps de fonctionnement prévu. Le nombre de pannes, leur fréquence et la durée moyenne des réparations servent à expliquer l’évolution observée.
La prochaine action consiste à sélectionner une ligne prioritaire, établir sa référence de disponibilité sur une période représentative et engager les premières analyses sur ses défaillances dominantes. Un bilan mensuel des arrêts, des corrections validées et des récidives permettra de déterminer si la trajectoire vers l’objectif de six mois est crédible.
Comment calculer une réduction de 50 % des arrêts non planifiés ?
Pour mesurer une réduction de moitié, comparer la durée cumulée des arrêts non planifiés à une situation initiale représentative, à périmètre et activité comparables. Par exemple, une valeur de référence hypothétique de 100 heures ramenée à 50 heures correspond à une diminution de 50 %. Lorsque les volumes ou les heures de fonctionnement changent, utiliser également un indicateur normalisé évite les conclusions trompeuses.
Combien de temps faut-il observer une machine pour confirmer l’efficacité d’une correction ?
La période dépend du rythme de fonctionnement, de la fréquence historique des pannes et des conditions nécessaires à leur apparition. Pour une défaillance rare, quelques semaines sans incident peuvent être insuffisantes. La validation doit porter sur une durée d’exposition représentative et conserver les mesures permettant de vérifier le mécanisme corrigé.
Une GMAO suffit-elle à identifier automatiquement les causes racines ?
Non. Une GMAO facilite la centralisation et l’exploitation des événements, mais l’identification des causes dépend de la qualité des données, des observations terrain et de la validation technique. Des descriptions incohérentes ou des arrêts mal attribués peuvent produire des classements trompeurs, même avec un logiciel performant.
Faut-il privilégier le MTBF ou le MTTR pour améliorer la disponibilité ?
Les deux indicateurs apportent des informations complémentaires. Le MTBF caractérise le temps moyen de fonctionnement entre défaillances pour les équipements réparables, tandis que le MTTR décrit la durée moyenne de réparation selon la définition retenue. Réduire la fréquence des défaillances et raccourcir les interventions contribuent ensemble à la disponibilité, mais leur importance respective dépend des pertes réellement observées.
Comment vérifier qu’une amélioration de disponibilité ne dégrade pas la qualité ?
Associer les indicateurs d’arrêts aux taux de rebuts, aux non-conformités, aux paramètres critiques du procédé et aux validations après intervention. Une remise en production accélérée n’est bénéfique que si les exigences de sécurité et de qualité sont respectées. Les résultats doivent être comparés dans des conditions de fabrication représentatives.